本文要点
- AI 测颜值学的是一群人打分的平均,比如 60 个人对 5,500 张标准正脸照的平均。
- 人和人本来就不一致:一群人的平均很稳,任意两个人之间只有中等一致。
- 测任何工具都问五个问题:分数从哪来、稳不稳、什么会让它变、相对谁、照片去了哪里。
- 稳不稳可以自己测:同样拍法连拍三张,各测一次,差值就是噪声。
颜值打分准不准?先问「准」是跟什么比
AI 颜值打分能做到的「准」,是接近一群人打分的平均,不是接近某个真相。
2018 年的一个常用数据集里,有 5,500 张正面、表情中性、没有遮挡的照片,每张由 60 位志愿者按 1–5 分打分,取平均当「答案」。模型好不好,看它的预测离这个平均有多远。
成绩分两档:只看几何比例的模型,和平均分的相关在 0.59–0.73;深度模型到 0.83–0.90,平均每张差约 0.23–0.29 分。
所以「准」的完整说法是:在这类标准正脸照上,接近这 60 个人的平均。换了照片或打分的人,就得重新验。
人和人本来就打不一样
打分的人自己就不一致。同一个数据集里,单个志愿者给的分,离平均通常差 0.6–0.7 分。
2000 年的一项元分析汇总了几十项研究:一群人的平均分非常稳定,同一文化内约 .90,跨文化约 .94;任意两个人之间却只有中等一致,同一文化内约 .47。2016 年的一项研究算出,个人口味约占评分里有意义差异的 36–44%;同一个人隔一周再打,和自己的相关也只有约 0.80。
另一项研究里,人给自己打的分,比别人给的平均高约 1 分(7 分制)。
没有哪个分数能同时对上所有人。模型逼近的,是多数人大致会怎么看。
测任何颜值测试,都问这五个问题
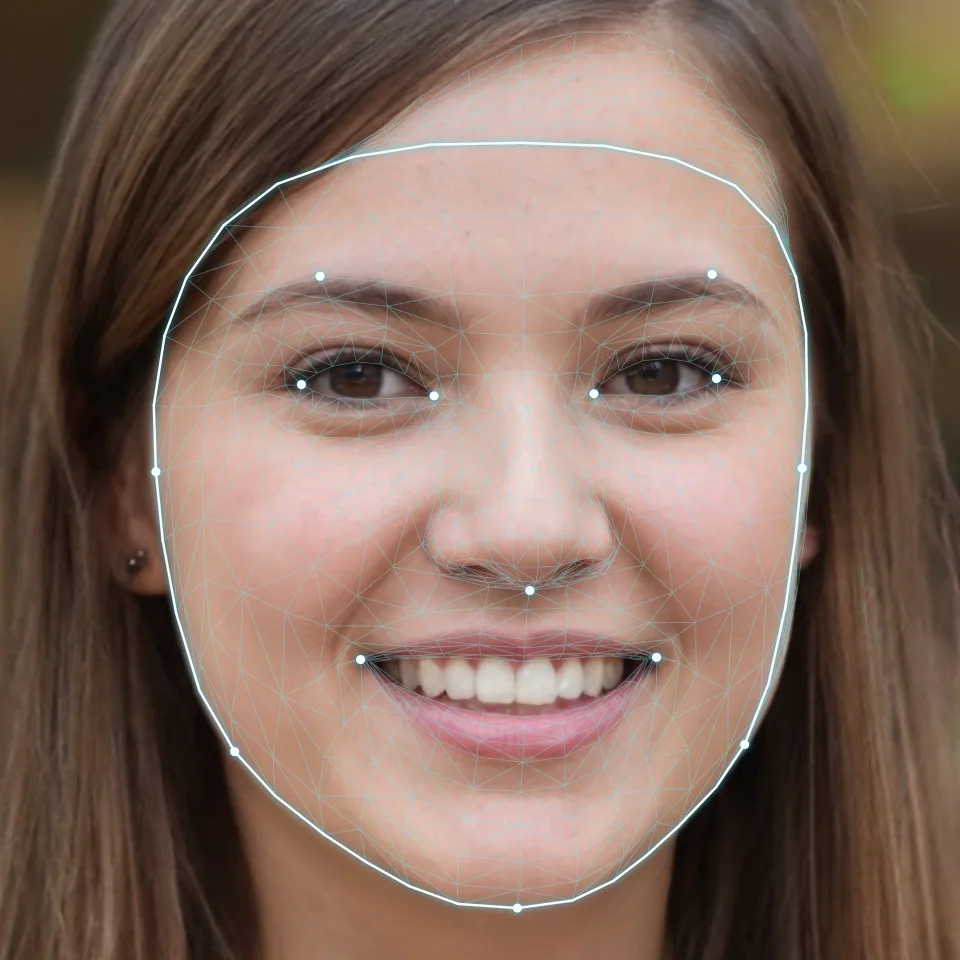
哪个工具都可以自己查这五件事:
- 分数从哪来? 从真人评分里学出来的,还是按固定公式算的,比如黄金比例。公式好算,但研究里它和评分的关系很弱,见黄金比例脸准吗。
- 稳不稳? 同一张脸、同样拍法的几张照片,结果差多少。
- 什么会让它变? 光线、角度、距离、表情、遮挡。
- 一个数相对谁? 跟哪一批脸、哪一批打分的人比出来的。
- 照片去了哪里? 在你的设备上分析,还是传到服务器。
上图是面部分析的第一步:找到几百个关键点,再从其中一些点读比例。点偏了,数就跟着偏。
自己验一验:同一张脸,换几张照片
2011 年一项研究请 40 人给 20 个人、每人 20 张照片打分。结果是:只要照片挑得合适,任意两个人「谁更好看」的结论都能反过来。一家颜值打分网站公布的分数也显示,分数挤在中段,平均 71.5、中位数 75,前 10% 在 84 分以上,差几分就是噪声;它重新校准过一次,旧分数就不能和新分数比了。
做法:同样的光、距离和表情,连拍三张,各测一次,看差多少;再只改一样,比如换成侧光。前一个差值是噪声,后一个才是这个变量的作用。拍法见正脸照怎么拍。
记住:分数描述的是一张照片,不衡量一个人的价值。
FacialRate 怎么做:五个问题的答案
- 分数从哪来:一个从真人评分里学出来的机器学习模型,不是挑好的固定公式;它用真人评分校准、测试过。
- 稳不稳:它会直说,分数描述的是这张照片。光线、角度和表情会改变模型看到的脸,同一个人换一张照片,读数可能不同。
- 会给什么建议:只涉及拍照、发型、妆容和护肤,不涉及医疗。
- 一个数相对谁:评分基准(女性或男性)由你自己选,不会从照片里推断。也不只一个数:免费的颜值报告有颜型、最强的一项、三个亮点、11+ 项维度的解读和一条可以试的建议。完整报告是可选的一次性购买,不是订阅。
- 照片去了哪里:检测和打分都在浏览器里完成,照片和由它生成的人脸图像都不会发到服务器;478 个面部关键点在浏览器里找到,分析时的网格也在你的设备上画出。
免费、不限次数,正好用来做上一节的对比。
这个系列接下来读什么
- 测颜值照片会上传吗:照片在哪里被分析,隐私政策该看哪几句。
- 为什么每次测的分数不一样:五个会改变照片的变量。
- 颜值打分怎么看:相对谁、误差多大、怎么拆开读。
- 什么样的脸好看:研究里一致的发现和边界。
常见问题
AI 测颜值比人打分更准吗?
这样比不太成立。模型学的是一群人打分的平均,能做到的是接近这个平均;你身边任何一个人的看法,本来就可能离平均差不少。
为什么两个颜值测试给我的分数差很多?
刻度、参照的脸和打分的人都不同,照片也可能不同。只有同一个工具、同样拍法的结果才能比。
分数低,说明我不好看吗?
不说明。分数描述的是这张照片在某一批人眼里大致会得到的印象,换照片、换打分的人都会变,它不衡量一个人的价值。